AI 数字人生成器 — 用 OmniHuman 1.5 把一张照片和一段音频变成会说话的数字人视频
AI 数字人生成器 能做什么?
VoooAI 是一款 AI 数字人生成器,只需一张人像照片和一段音频,就能生成真实、唇形同步的会说话数字人视频。底层由 OmniHuman 1.5 提供音频驱动的人物动画,由 Seed Audio 1.0 提供预置音色旁白,可用于新闻播报、产品讲解、企业代言与社媒短视频——无需摄像机、无需演员、无需演播室。
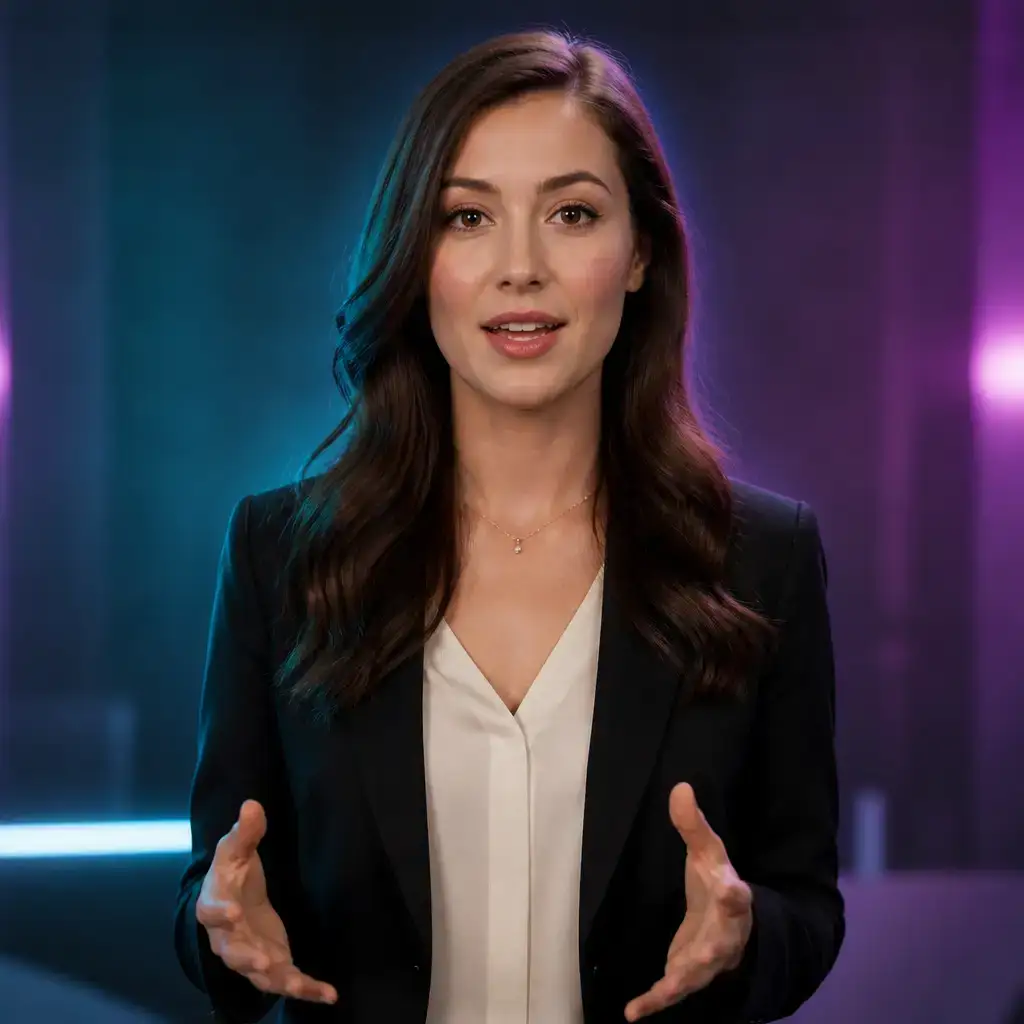
什么是 AI 数字人生成器?
AI 数字人生成器,是把一张静态人像和一段声音,转化为一个会说话的主播。你不需要实拍真人,只要上传一张照片、提供一段音频,引擎就会驱动面部、头部与肩部动作,生成唇形准确、表情自然的讲话画面。VoooAI 的这一能力建立在 OmniHuman 1.5 之上——这是一款支持音频驱动的专业人物视频引擎:你提供的音频会直接驱动口型、眨眼与头部运动,因此从第一个字到最后一个字都保持同步。声音部分则由 Seed Audio 1.0 完成,它是一款按实际时长计费的预置音色语音合成引擎,你可以在几秒内生成一段干净的旁白,也可以用你自己录制好的音频来驱动数字人。
真正的优势在于数字人周围的工作流。在 VoooAI 的画布上,创建数字人只是整条流水线中的一个节点:先生成或准备人像,再创建会说话的数字人,然后添加旁白,最后把它与 B-roll、字幕、背景音乐和转场一起合成为成片。由于同一张画布还运行着视频引擎(Seedance 2.5、Kling、Wan2.6)、图像引擎(GPT Image 2、Seedream 5.0 Pro、Nano Banana 2)与音乐引擎(Suno v5),数字人从不孤立存在——它会成为一个完整营销、教育或播报作品的"主播层"。VoooAI 提供免费额度与每日赠点,让你在投入完整制作之前,先低成本验证一个代言形象。
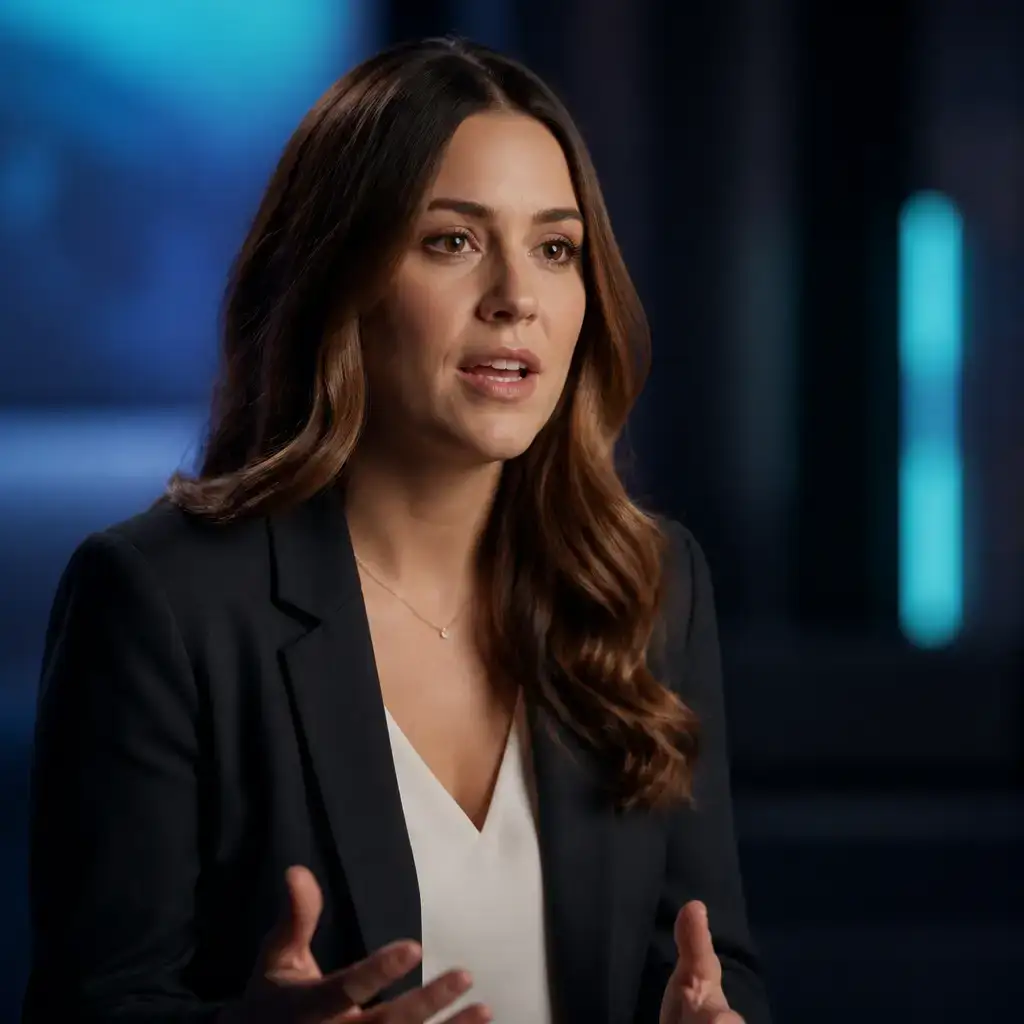
数字人背后的两款引擎与一块画布
OmniHuman 1.5 — 音频驱动的会说话人像
OmniHuman 1.5 是 VoooAI 数字人核心的专业人物视频引擎。它接收一张人像照片加一段音频,生成真实的会说话人像:口型、眨眼与头部运动全部由音频驱动。无需手动关键帧,成片即可保持完美同步。
Seed Audio 1.0 — 预置音色旁白
Seed Audio 1.0 是一款按实际音频时长计费的语音合成引擎,内置多种预置音色。你可以用它生成驱动数字人的旁白,也可以提供你自己录制的音频。它是一款配音/旁白引擎——画布上的音乐则由 Suno v5 负责。
多模型画布 — 合成完整视频
单独一个会说话的人像往往不是最终交付物。VoooAI 节点画布让你把数字人与来自 Seedance 2.5 或 Kling 的 B-roll、来自 GPT Image 2 的产品图、字幕以及 Suno v5 背景音乐放在一起,一次性导出合成视频——无需外部剪辑软件。
使用方式 — 从人像到主播
1. 上传一张人像照片
提供一张清晰的正脸人像。可以用真实照片,也可以用图像画布生成的角色。这张人像决定了主播的外观、着装与背景。
2. 添加音频或生成旁白
录制你自己的配音,或用 Seed Audio 1.0 预置音色生成一段旁白。这段音频会驱动数字人的唇形同步。
3. 生成会说话的人像
OmniHuman 1.5 根据音频驱动人像,生成表情自然、口型准确的真实讲话片段。
4. 合成并导出
把数字人拖到画布上,与 B-roll、字幕、转场和音乐组合,然后在符合条件的付费计划上导出无水印视频,用于播报、社媒或在线教育。
谁在使用 VoooAI 数字人
新闻与播报团队
为新闻综述、产品快讯与内部公告生成风格一致的主播片段,无需预约演播室,也不必等档期。
教育与培训
把课件脚本与入职文档转化为由主播讲解的视频。同一个数字人能让一门课程在几十个模块之间保持视觉一致。
企业与产品演示
为产品发布、功能演示与投资人更新赋予一张"人脸"。本地化旁白后,几分钟内就能为不同市场重新渲染同一位代言人。
社媒短视频与 UGC 风格广告
为 TikTok、Reels 与 Shorts 制作 9:16 竖屏主播片段。批量渲染不同钩子版本,并让整个 campaign 中的数字人形象保持稳定。
Synthesia 与 HeyGen 的实用替代方案
Synthesia 和 HeyGen 让 AI 数字人走红,但创作者常常遇到同样的天花板:锁死的库存形象库、按席位收费的订阅,以及一个"除了数字人什么都做不了"的独立工具。VoooAI 走的是另一条路:你的数字人从你自己的肖像出发,由 OmniHuman 1.5 驱动,并与视频、图像、音乐引擎共处同一张多模型画布。你不必先导出一个孤立的说话头像、再到别处二次剪辑,而是在同一条工作流里完成整支片子——B-roll、字幕、Suno v5 配乐——然后直接发布到你真正变现的渠道。
免费额度起步 — 无需演播室
VoooAI 提供无需信用卡的免费额度与每日赠点,让你在付费前就能生成并预览数字人。付费计划解锁无水印导出、更高渲染配额以及符合条件引擎的商用授权。由于 Seed Audio 1.0 的旁白按实际音频时长计费,你只需为真正产出的秒数付费——没有演播室式的最低套餐门槛。
常见问题
什么是 AI 数字人生成器?
VoooAI 数字人由哪款引擎驱动?
我必须自己录音吗?
可以用我自己的照片当主播吗?
唇形同步是自动的吗?
VoooAI 数字人可以商用吗?
视频有水印吗?
可以把数字人和视频、音乐组合起来吗?
免费创建你的第一个 AI 数字人
上传一张人像,添加旁白,几分钟内渲染出唇形同步的主播。无需信用卡,每日免费额度,付费计划无水印。
免费试用 VoooAI